Sistemele distribuite pot genera mai multă telemetrie decât o echipă își permite să păstreze sau să investigheze eficient. Serviciile, reîncercările și joburile de fundal multiplică span-urile chiar dacă traficul clienților crește puțin. O strategie practică de observabilitate trebuie să stabilească ce colectează, ce păstrează și cum detectează pierderile din pipeline.
OpenTelemetry oferă un loc potrivit pentru aceste decizii, în afara logicii aplicației. Ghidul propune o arhitectură de pornire, nu un procent universal de eșantionare și nici o reducere garantată a costurilor.
Măsoară mai întâi volumul facturabil
Înregistrează span-urile primite pe secundă, octeții exportați, numărul mediu de span-uri pe trasă și retenția backend-ului. Separă traficul aplicației de verificările de sănătate și probele sintetice. Află dacă backend-ul facturează ingestia, stocarea, câmpurile indexate sau o combinație.
Măsoară și CPU-ul și memoria Collector-ului. Reducerea ingestiei în backend prin mutarea procesării într-un Collector nu elimină costul acelei procesări. O bază de comparație utilă include infrastructura de colectare și timpul necesar inginerilor pentru a găsi o cerere eșuată reprezentativă.
Alege momentul deciziei de eșantionare
Eșantionarea inițială, numită head sampling, decide aproape de începutul unei trase și păstrează relativ puțină stare. Eșantionarea finală, tail sampling, așteaptă span-uri și poate folosi rezultate observate, precum erorile sau latența. Totuși, nu poate recupera span-uri deja eliminate de SDK-ul aplicației.
Documentația procesorului tail sampling descrie politicile și stocarea temporară necesară. Confirmă că distribuția Collector aleasă include procesorul și validează configurația pentru versiunea exactă pe care o instalezi.
Trimite fiecare trasă către aceeași instanță de eșantionare
Un load balancer round-robin obișnuit poate împărți span-urile aceleiași trase între mai multe instanțe. Fiecare vede atunci doar o parte din cerere. Rutează după trace ID înaintea nivelului de eșantionare, astfel încât span-urile asociate să ajungă la aceeași instanță.
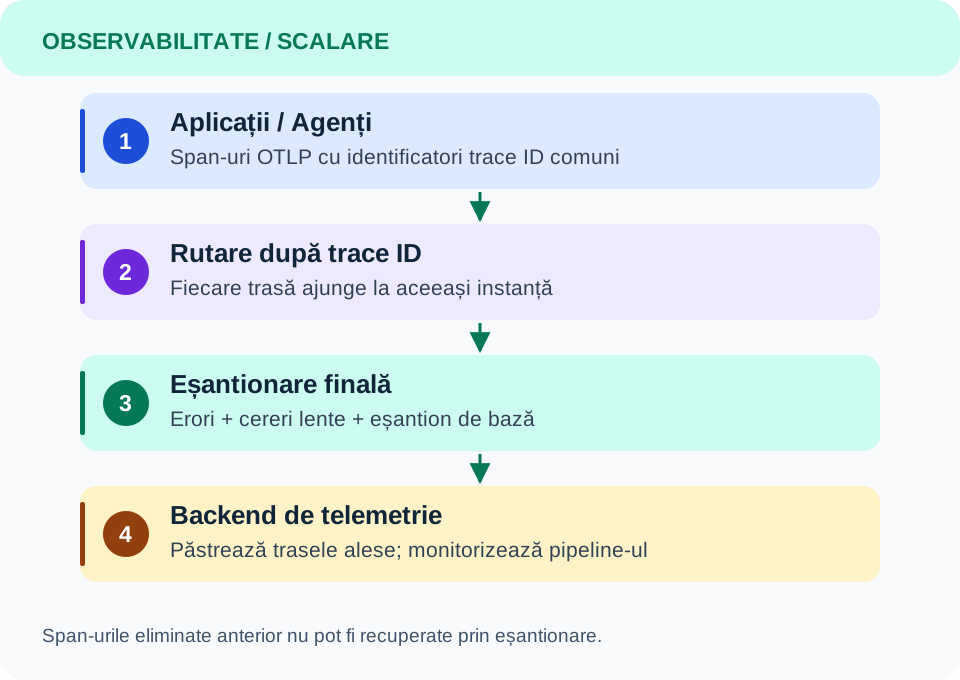
Ghidul de deployment gateway OpenTelemetry descrie această organizare cu un exporter de load balancing înaintea Collector-elor care fac tail sampling. Scalarea necesită atenție, deoarece schimbarea instanțelor disponibile poate modifica distribuția traselor.
Începe cu o politică simplă
O politică inițială poate păstra trasele cu erori, trasele care depășesc un prag de latență și un eșantion redus din rest. Acesta este un fragment ilustrativ pentru procesor, nu o configurație Collector completă:
processors:
  tail_sampling:
    decision_wait: 15s
    num_traces: 50000
    policies:
      - name: errors
        type: status_code
        status_code:
          status_codes: [ERROR]
      - name: slow-requests
        type: latency
        latency:
          threshold_ms: 1500
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 5
Conectează procesorul la un pipeline de trase cu receivere și exportere. Pentru aceste politici simple, potrivirea oricăreia poate determina păstrarea trasei; eșantionul de bază nu limitează volumul total exportat la cinci procente. În timpul unui incident, politica de erori poate păstra mult mai mult trafic decât în mod normal.
Valorile sunt exemple. Alege intervalul de decizie din întârzierile observate ale span-urilor, inclusiv activitatea asincronă. Estimează numărul de trase active înmulțind trasele noi pe secundă cu intervalul de decizie, adaugă rezervă și testează memoria sub sarcină. Numărul traselor nu este suficient: ele conțin span-uri de dimensiuni și cantități diferite.
Monitorizează Collector-ul ca pe un serviciu de producție
Urmărește refuzurile de recepție, erorile de export, presiunea asupra cozilor, restarturile și deciziile de eșantionare prin metricile versiunii instalate. Aplică protecția memoriei la începutul pipeline-ului, configurează cozi și reîncercări cu limite și stabilește comportamentul în cazul indisponibilității backend-ului.
Exclude de la sursă credențialele și corpurile sensibile ale cererilor. Elimină atributele necesare înainte de export. Eșantionarea controlează volumul, nu reprezintă o barieră de confidențialitate.
Extinde configurația pe baza rezultatelor de depanare
Testează noul pipeline pe un singur serviciu. Compară volumul exportat, resursele Collector-ului, completitudinea traselor și posibilitatea de a găsi erorile cunoscute. Introdu o eroare controlată și o cerere lentă, apoi identifică-le în backend.
Păstrează contoare de cereri neeșantionate sau alte metrici potrivite pentru calculul ratelor și disponibilității. Un set de trase orientat intenționat spre erori nu trebuie tratat ca o măsurătoare nepărtinitoare a ratei de eroare.
Extinde configurația numai după îndeplinirea unor criterii explicite: trasele sunt utile, colectarea rămâne stabilă la vârfuri de trafic și ingestia facturată scade efectiv. Revizuiește politica atunci când se schimbă profilul traficului sau responsabilitatea serviciilor.