Menținerea infrastructurii cloud necesită tratarea copiilor de rezervă ca ipoteze neverificate până când sunt probate prin exerciții regulate de restaurare. Multe echipe de inginerie SaaS investesc masiv în programe automate de snapshot-uri, reguli de replicare și politici de păstrare pe termen lung, dar omit să verifice dacă aceste date pot reînvia o instanță de baze de date funcțională în limite operaționale acceptabile. Un plan de recuperare care nu a supraviețuit niciodată unei simulări live este doar o colecție de presupuneri optimiste care riscă să eșueze în timpul unei pene reale de producție. Construirea unei strategii de recuperare reziliente înseamnă mutarea atenției de la simpla acumulare de date la mecanici de restaurare riguroase și verificabile.
Realitatea Restaurării și Modurile Comune de Eșec
Cel mai comun mod de eșec în timpul unei căderi în cloud nu este pierderea datelor, ci descoperirea faptului că procesul de recuperare depinde de cunoștințe nescrise sau pași manuali. Adesea, inginerii presupun că, deoarece furnizorul cloud raportează finalizarea zilnică a unui snapshot, schema bazei de date, extensiile și configurațiile se vor alinia perfect la rehidratare. În practică, variabilele de mediu lipsă, definițiile invechite de infrastructură ca cod și scripturile de migrare neaplicate blochează frecvent secvențele de pornire. În plus, dependențele de furnizori externi de identitate sau chei KMS proprietare eșuează adesea când țintele sunt pornite în zone izolate de recuperare. Recunoașterea acestor puncte slabe necesită execuția regulată a exercițiilor care testează mai mult decât simpla stocare brută.
Proiectarea unui Mediu Sandbox Izolat pentru Teste
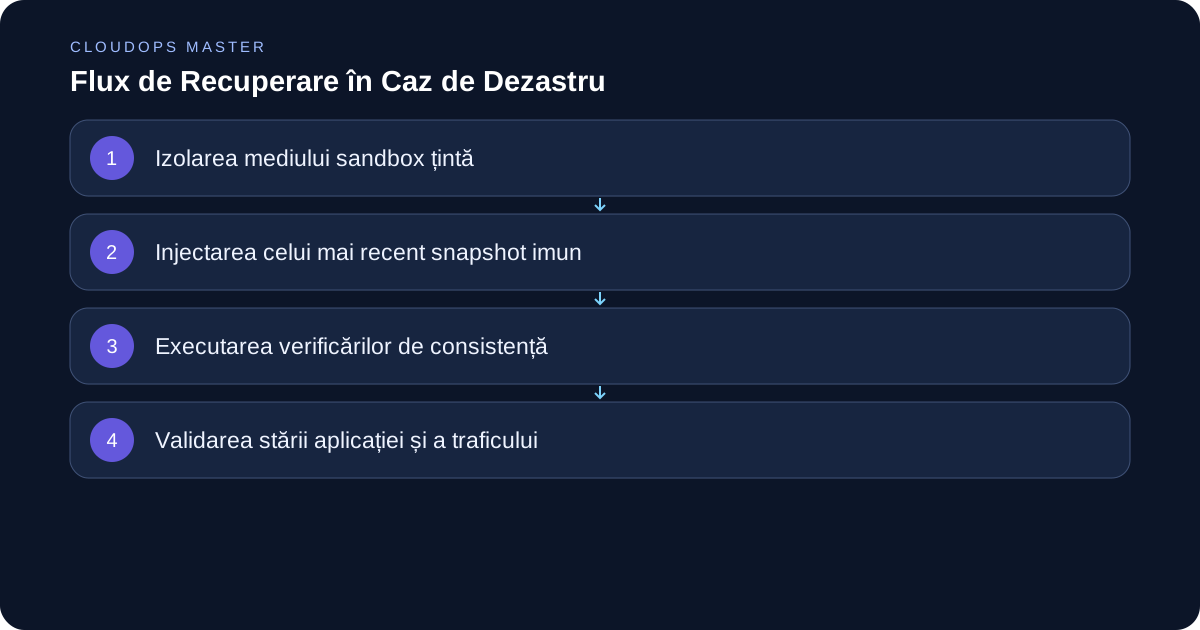
Executarea unui test de recuperare pe mediile de producție sau staging introduce riscuri inacceptabile de corupție a datelor sau întrerupere accidentală a serviciilor. Echipele trebuie să pună la dispoziție un mediu sandbox izolat și efemer care oglindește topologia de producție fără a partaja rețeaua activă sau limitele de securitate. Acest sandbox servește drept cameră curată unde scripturile automate pot prelua snapshot-uri, atașa volume de stocare secundare și porni instanțe de calcul. Menținând o izolare strictă, inginerii pot măsura metrici de performanță reale fără a afecta traficul utilizatorilor. Când configurați acest sandbox, asigurați-vă că datele de autentificare și sistemele de gestionare a secretelor sunt inițializate independent pentru a preveni dependențele ascunse de starea de producție.
Automatizarea Pipeline-ului de Recuperare de la Capăt la Capăt
Procedurile manuale de recuperare sunt predispuse la erori umane, timpi de execuție lenți și panică în timpul incidentelor majore. Pentru a obține timpi de recuperare predictibili, echipele trebuie să codifice întreaga secvență de restaurare în conducte automate. Aceasta implică scriptarea extragerii celor mai recente identificatoare de snapshot, alocarea straturilor de calcul și rețea prin infrastructură ca cod, executarea rutinei de import a bazei de date și lansarea sondelor de sănătate. Scripturile de automatizare ar trebui să gestioneze cazurile limită, cum ar fi așteptarea ca serviciile dependente să devină responsive înainte de a direcționa traficul de test. Transformând recuperarea într-un pipeline repetabil, echipele elimină incertitudinea.
Măsurarea Obiectivelor de Timp și Punct de Recuperare
Fără măsurători empirice, obiectivele de timp de recuperare și punct de recuperare rămân presupuneri arbitrare scrise în documentele de conformitate. Testele de restaurare de rutină oferă telemetria exactă necesară pentru a valida aceste metrici în condiții de sarcină reală. Echipele ar trebui să înregistreze marcajul temporal exact în care este declanșat un scenariu de dezastru, să urmărească durata fiecărei faze din pipeline și să noteze vechimea exactă a datelor restaurate. Dacă testul relevă că recuperarea durează patru ore în loc de ora țintită, inginerii pot investiga sistematic blocajele — cum ar fi lățimea de bandă scăzută la descărcarea snapshot-urilor — și pot refactora fluxul de lucru în consecință.
Lista de Verificare pentru Restaurarea Backup-ului de Producție
- Definiți obiective explicite RTO și RPO bazate pe criticitatea afacerii.
- Alocați un mediu sandbox complet izolat pentru rularea simulărilor de recuperare de rutină.
- Automatizați selectarea snapshot-urilor, alocarea infrastructurii și importul datelor prin scripturi controlate.
- Executați exerciții programate fără avertisment prealabil pentru a testa pregătirea echipei și acuratețea manualelor.
- Măsurați timpul total scurs și prospețimea datelor la fiecare restaurare pentru a identifica blocajele de performanță.
Concluzie
Restaurarea copiilor de rezervă în cloud nu este o poliță de asigurare pasivă; este o disciplină inginerească activă care necesită validare continuă. Renunțând la încrederea oarbă în snapshot-urile automate și adoptând exerciții riguroase în sandbox, echipele SaaS pot transforma planurile teoretice de recuperare în capabilități operaționale sigure. Testarea regulată descoperă lacune ascunse de configurare, validează metricile critice RTO și RPO și garantează că, în cazul unor eșecuri neașteptate, organizația poate restabili stabilitatea serviciilor cu o certitudine absolută.