Cele mai multe echipe de inginerie mențin rutine robuste de backup pentru bazele de date și stocarea de obiecte în cloud, dar multe eșuează în a verifica dacă acele copii de siguranță pot fi restaurate cu succes. O politică de backup fără teste periodice de recuperare este doar o ipoteză neverificată. În medii cloud care se întind pe mai multe regiuni și au dependențe complexe, asumarea integrității datelor bazată exclusiv pe jurnalele de finalizare reprezintă un risc operațional critic. Acest ghid explorează modul de proiectare, automatizare și executare a testelor practice de restaurare pentru arhitecturile SaaS moderne.
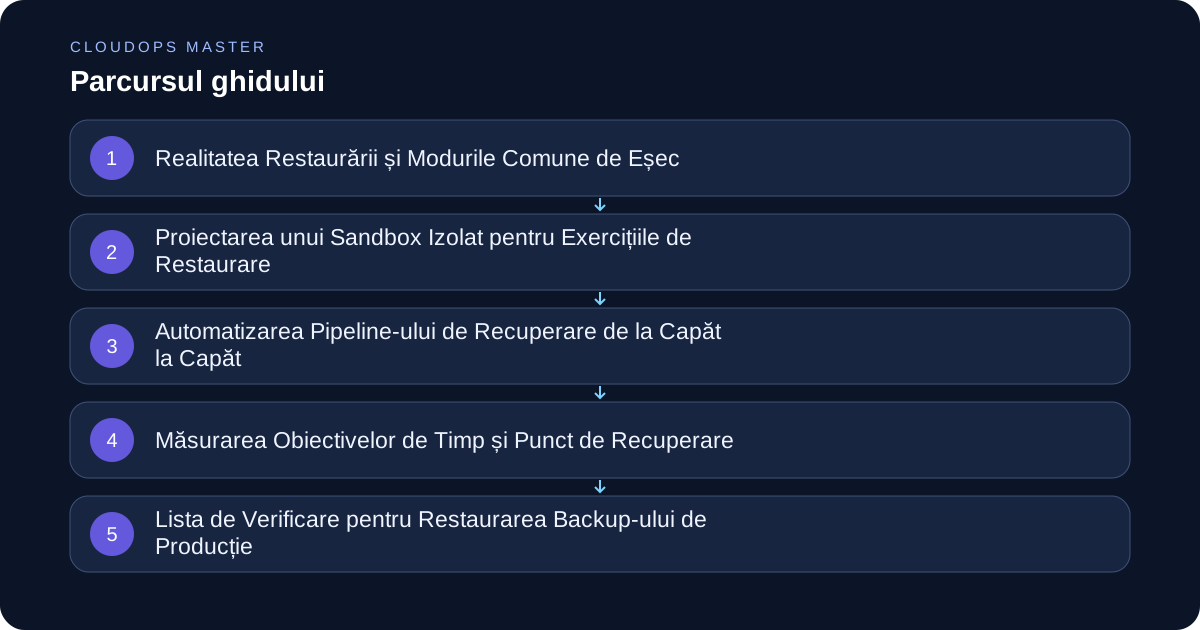
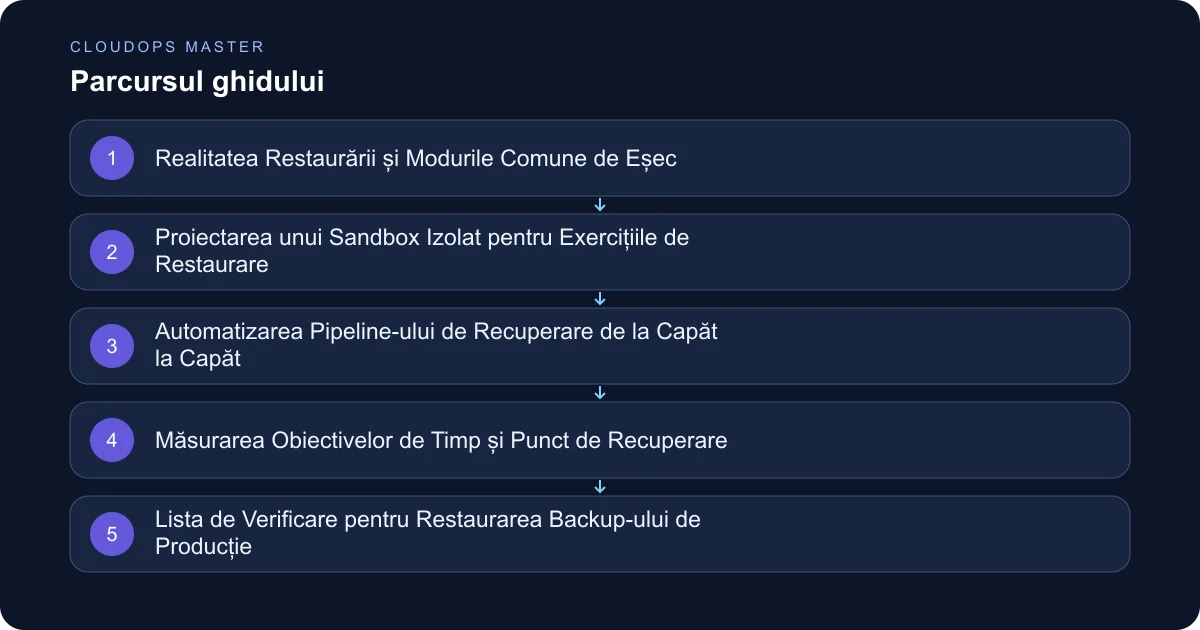
Realitatea Restaurării și Modurile Comune de Eșec
Sarcinile de backup raportează adesea succesul în timp ce capturează stări incomplete, fișiere index corupte sau chei criptografice lipsă. Când survine un dezastru, echipele descoperi că procedurile lor de restaurare se bazează pe pași manuali cunoscuți doar de inginerii care au plecat, sau că dependențe precum valorile din managerul de secrete și politicile de rețea au fost excluse din domeniul de aplicare a instantaneului. Un proces de recuperare fiabil trebuie să ieșe în întâmpinarea evoluției schemelor, a barierelor de permisiune și a volumelor de stocare orfane care nu reușesc să se atașeze corect în mediile țintă. Înțelegerea acestor moduri de eșec ajută echipele să treacă de la stocarea pasivă a datelor la ingineria activă a fiabilității.
Proiectarea unui Sandbox Izolat pentru Exercițiile de Restaurare
Testarea restaurărilor în interiorul clusterelor de producție sau staging introduce riscuri inacceptabile de suprascriere a datelor și expunere a securității. În schimb, echipele de inginerie ar trebui să provizioneze medii sandbox efemere utilizând Infrastructure as Code. Această țintă izolată trebuie să oglindească topologiile de rețea de producție, politicile de control al accesului și configurările de stocare suficient de aproape pentru a valida procesul de restaurare, rămânând totuși complet protejată de traficul live. Stivele de validare efemere permit, de asemenea, echipelor să ruleze teste de integrare automate împotriva datelor restaurate pentru a asigura compatibilitatea aplicației înainte de a considera exercițiul încheiat.
Automatizarea Pipeline-ului de Recuperare de la Capăt la Capăt
Exercițiile manuale de restaurare suferă de programe neregulate de execuție și eroare umană. Pentru a menține disponibilitatea operațională, echipele ar trebui să scrie un script pentru întregul flux de lucru de recuperare. Acest pipeline trebuie să preia programatic cel mai recent artefact de backup verificat, să provizioneze infrastructura de testare izolată, să injecteze instantaneul în baza de date țintă sau în magazinul de obiecte și să execute teste de fum împotriva punctelor finale restaurate. Programarea acestei automatizări să ruleze săptămânal sau lunar asigură că derivarea tăcută a configurației dintre codul infrastructurii și instantaneele de backup este detectată imediat, mai degrabă decât în timpul unei întreruperi.
Măsurarea Obiectivelor de Timp și Punct de Recuperare
Viteza de execuție contează la fel de mult ca integritatea datelor în timpul unui eveniment catastrofal. Testele de restaurare a backup-urilor oferă singura metodă fiabilă de a măsura empiric obiectivele de timp și punct de recuperare. Cronometrând fiecare fază a pipeline-ului automatizat - de la descărcarea inițială a artefactului până la disponibilitatea finală a aplicației - inginerii pot identifica blocajele, cum ar fi debitul lent al rețelei în timpul descărcărilor de instantanee sau reconstrucțiile lungi de index. Urmărirea acestor metrici în timp stabilește acorduri de nivel de serviciu realiste și evidențiază momentul în care nivelurile de stocare necesită optimizare.
Lista de Verificare pentru Restaurarea Backup-ului de Producție
- Programați exerciții săptămânale automate de restaurare în medii sandbox izolate.
- Verificați dacă cheile de criptare și secretele necesare pentru decriptare sunt salvate în siguranță alături de date.
- Măsurați și înregistrați metricile reale ale obiectivelor de timp și punct de recuperare în timpul fiecărui test.
- Implementați teste de integrare post-restaurare pentru a valida funcționalitatea aplicației și consistența datelor.
- Documentați toate soluțiile de ocolire manuală întâlnite în timpul testării și convertiți-le în cod automatizat.
- Restricționați accesul la pipeline-urile de restaurare utilizând un control strict al accesului bazat pe roluri și jurnalizarea auditului.
Concluzie
Backup-urile sunt valoroase doar în măsura în care le puteți restaura sub presiune. Trecând de la încercări de recuperare manuale și ad-hoc la exerciții de restaurare automate și frecvente, echipele de inginerie pot elimina incertitudinea și pot garanta reziliența operațională. Tratați fiecare backup ca fiind neverificat până la proba contrarie prin verificare sistematică și asigurați-vă că strategia de recuperare în caz de dezastru este pregătită pentru neprevăzut.