Migrarea aplicațiilor de producție de la mașini virtuale tradiționale la platforme de containere reprezintă un moment de referință arhitecturală pentru orice echipă de inginerie SaaS. Deși containerele oferă o livrare mai rapidă, izolare previzibilă a mediului de execuție și scalare mai simplă, mutarea sarcinilor de lucru vechi fără o strategie atentă poate introduce întreruperi neprevăzute și fricțiune operațională. Acest articol prezintă o abordare metodică pentru tranziția de la mașini virtuale la containere, minimizând în același timp riscurile.
Auditul Dependențelor și al Ipotezelor de Rulare
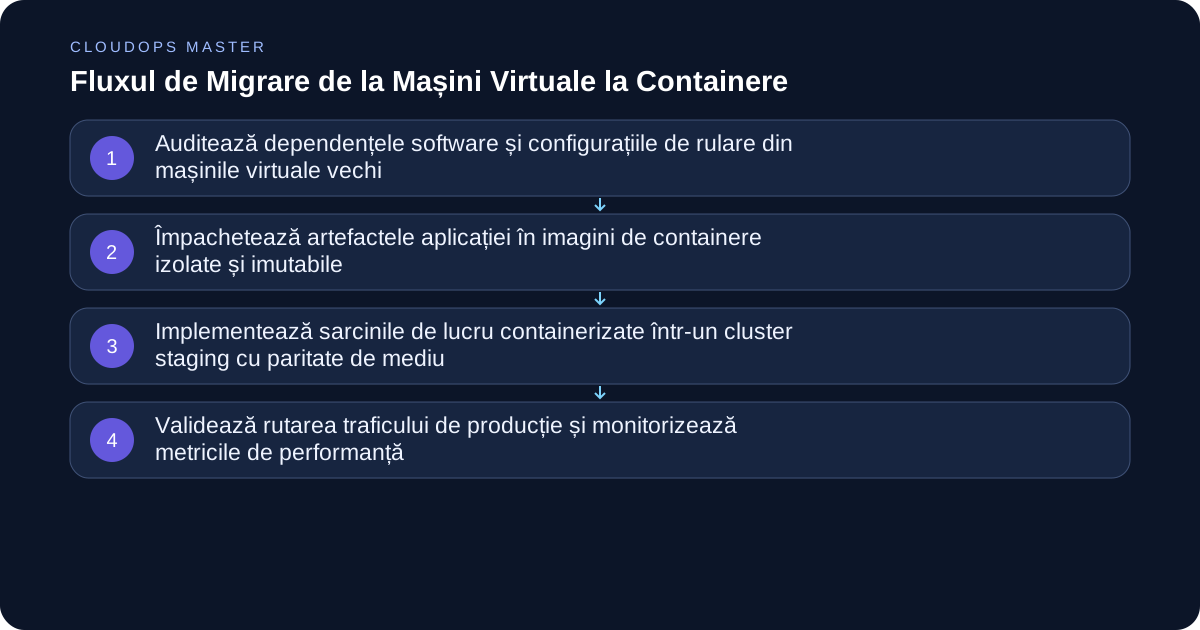
Înainte de a scrie un singur fișier container, trebuie să inventariați exact ipotezele de rulare ale sarcinilor de lucru din mașinile virtuale vechi. Mașinile virtuale ascund adesea derive de configurare, instalări manuale de pachete și dependențe implicite de sistemul de fișiere care se pot defecta în interiorul containerelor imutabile. Începeți prin a examina instrumentele de management al configurării, scripturile de pornire și definițiile serviciilor systemd. Documentați fiecare variabilă de mediu, cale de stocare persistentă și dependență de rețea externă cerută de aplicație.
Compromisurile apar atunci când aveți de-a face cu dependențe vechi și orientate spre stare. Dacă o aplicație monolitică se bazează puternic pe scrieri locale pe disc sau pe adrese IP hardcodate, containerizarea acesteia direct va eșua. Echipele trebuie să decidă dacă vor refactoriza aplicația pentru a folosi stocare de obiecte și configurare bazată pe mediu înainte de containerizare, sau dacă vor rezolva aceste datorii arhitecturale în paralel într-un mediu de staging.
Containerizarea Artefactelor Aplicației
Odată ce cerințele de rulare sunt documentate, transformați-le într-o imagine de container sigură și minimală. Evitați utilizarea imaginilor de bază supraîncărcate care includ utilitare de depanare inutile, manageri de pachete sau interpretoare de comenzi, deoarece acestea extind suprafața de atac a lanțului de aprovizionare software. Construcțiile în etape multiple (multi-stage builds) ajută la separarea mediului de compilație de mediul de execuție de producție, asigurând că doar binarele necesare sunt livrate.
Când scrieți definițiile de construcție, fixați sumele de control (digests) ale imaginii de bază în loc să folosiți etichete mutabile, pentru a garanta construcții deterministe. Gestionați managementul proceselor cu atenție; runtime-urile standard de containere se așteaptă ca procesul principal al aplicației să ruleze ca PID 1 și să redirecționeze corect semnalele POSIX. Dacă runtime-ul vechi se bazează pe instrumente de supraveghere multi-proces, adoptați un sistem de inițializare adecvat conceput pentru containere, în loc să încercați să replicați o mașină virtuală completă în interiorul unui singur container.
Gestionarea Configurării și a Datelor Persistente
Containerele sunt concepute să fie efemere, ceea ce intră în conflict direct cu modelele tradiționale de stocare din mașinile virtuale. Într-o mașină virtuală, fișierele de configurare și jurnalele (logs) se află adesea direct pe discurile locale. Pentru containere, toată configurarea trebuie injectată extern prin variabile de mediu, secrete montate sau hărți de configurare, în timp ce jurnalele aplicației trebuie transmise direct către stdout și stderr pentru ingestie centralizată.
Datele persistente necesită o planificare atentă cu privire la ciclurile de viață ale volumelor și clasele de stocare. Motoarele de baze de date, cache-urile locale și directoarele de încărcare a fișierelor nu pot trăi în interiorul stratului de container efemer. Măsurați stocarea externă administrată sau cererile de volume persistente în mod explicit și testați scenariile de eșec în care un container se prăbușește și repornește pe o altă nod-gazdă pentru a vă asigura că integritatea datelor este menținută.
Stabilirea Parității în Mediile de Staging
Nu promovați niciodată sarcinile de lucru containerizate direct de pe stația de lucru a unui dezvoltator în producție. Aveți nevoie de un cluster staging dedicat care să oglindească mediul de producție țintă în ceea ce privește politicile de rețea, rezoluția DNS, gestionarea secretelor și rutarea traficului de intrare (ingress). Rulați suite de teste de integrare împotriva acestui mediu de staging pentru a prinde regresii subtile în performanță, limite de memorie sau limitare de CPU (throttling).
Acordați o atenție deosebită cererilor și limitelor de resurse. Mașinile virtuale rulează adesea cu alocări generoase și neconstrânse de resurse, în timp ce containerele necesită granițe explicite pentru a preveni epuizarea resurselor sau efectele de vecin zgomotos. Analizați metricile istorice din mașinile virtuale vechi pentru a seta cereri realiste de CPU și memorie care previn oprirea din cauza epuizării memoriei în timpul vârfurilor de trafic.
Tranziția Traficului și Strategii de Revenire (Rollback)
Când aveți încredere în validarea din staging, planificați o treptată mutare a traficului în loc de o migrare bruscă de tip big-bang. Folosiți ponderarea DNS, grupuri țintă de load balancer sau rutare prin service mesh pentru a direcționa un procent mic din traficul de producție către noua implementare containerizată. Monitorizați cu atenție ratele de eroare, percentilele de latență și metricile de saturație înainte de a crește cota de trafic.
Mențineți o cale activă de rezervă către mașinile virtuale vechi pe parcursul ferestrei de tranziție. Dacă apar regresii critice, echipa dumneavoastră trebuie să poată reveni instantaneu la configurația de rutare anterioară. Țineți mașinile virtuale vechi în stare de așteptare caldă (warm standby) pentru o perioadă definită de observare înainte de a le dezafecta.
Lista de Verificare pentru O Migrare cu Risc Redus
- Inventariați toate fișierele de configurare vechi, joburile cron și serviciile systemd.
- Construiți imagini de containere minimale, în etape multiple, cu sume de control fixate.
- Externalizați toate secretele de rulare și parametrii de configurare.
- Transmiteți jurnalele aplicației către ieșirea standard pentru colectare centralizată.
- Configurați cereri și limite explicite de resurse pentru CPU și memorie.
- Configurați un cluster staging care oglindește politicile de rețea din producție.
- Implementați mutarea treptată a traficului folosind rutarea load balancerului.
- Mențineți mașini virtuale în standby cald pentru reveniri rapide de urgență în caz de eșec.
Concluzie
Tranziția de la mașini virtuale la containere este în mod fundamental un exercițiu de disciplină operațională, și nu doar o simplă împachetare de cod. Prin auditarea amănunțită a dependențelor vechi, externalizarea configurării, stabilirea unor limite stricte de resurse și executarea unor tranziții treptate ale traficului, echipele de inginerie își pot moderniza infrastructura fără a risca încrederea clienților sau fiabilitatea sistemului.