Introducere
Optimizarea costurilor în cloud compromite frecvent fiabilitatea sistemului atunci când echipele execută reduceri bazate exclusiv pe totalurile lunare brute. Reducerea agresivă a capacităților, achiziția indiscriminată de rezervări și eliminarea nevalidată a resurselor declanșează adesea creșteri latente ale latenței, eșecuri în cascadă sau degradarea neașteptată a performanței în intervalele de trafic maxim. Ingineria financiară sustenabilă necesită măsurători de bază cuprinzătoare înainte de a efectua orice refactorizare cu impact distructiv.
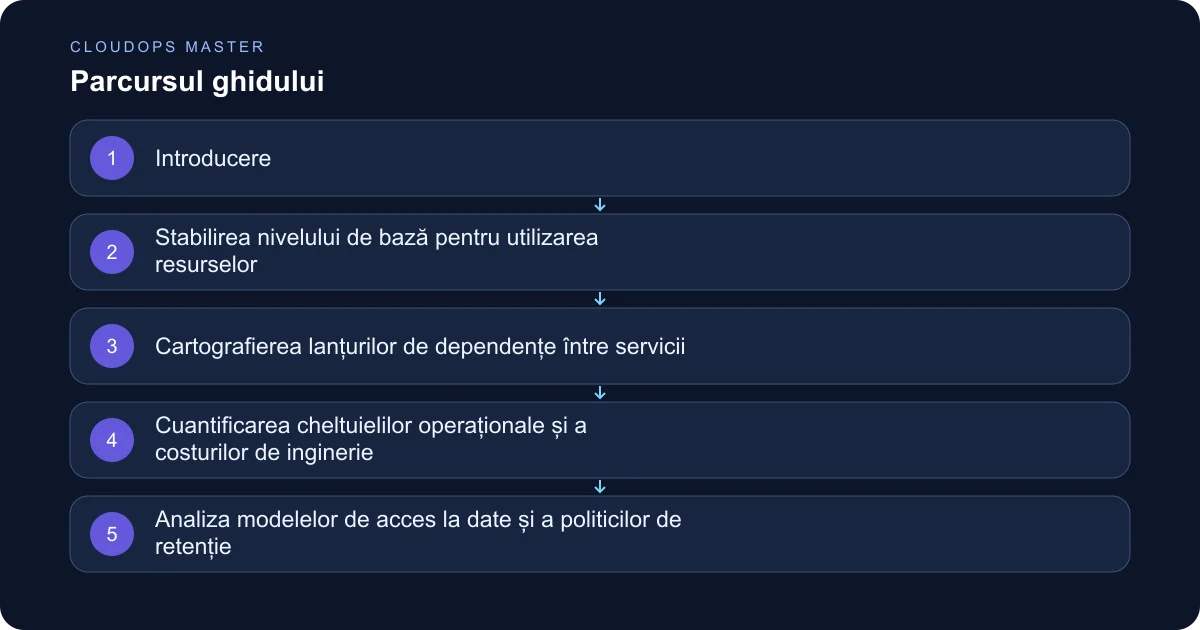
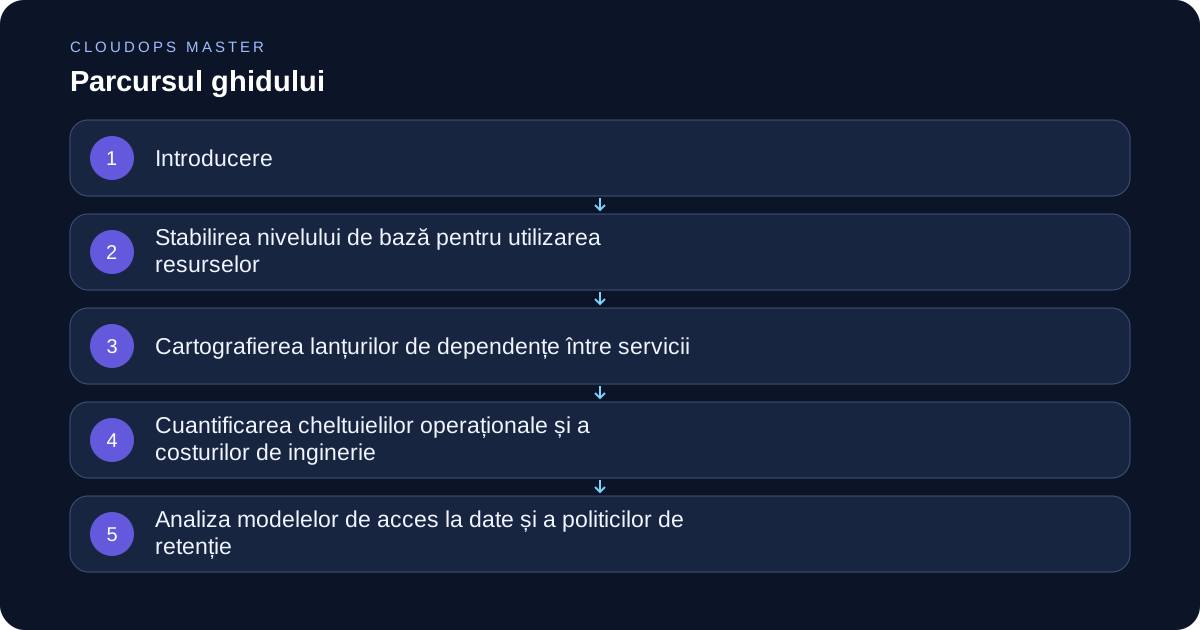
Stabilirea nivelului de bază pentru utilizarea resurselor
Tablourile de bord brute pentru alocarea costurilor reflectă rar eficiența reală a infrastructurii. Înainte de a ajusta dimensiunile instanțelor sau de a modifica nivelurile de stocare, echipele trebuie să agrege valori granulare ale utilizării resurselor pe parcursul unor cicluri operaționale complete. Pentru sarcinile de lucru de tip compute, aceasta presupune capturarea distribuției utilizării CPU, a metricilor de saturație a memoriei, a valorilor IOPS pentru disc și a debitului de rețea la intervale fine.
Un singur vârf de trafic săptămânal poate invalida metricile de utilizare medie. Echipele trebuie să analizeze modelele de utilizare P95 și P99 în loc să se bazeze pe medii aritmetice. Dacă o aplicație utilizează în medie 15 la sută din memoria alocată, dar experimentează un vârf de saturație de 95 la sută în timpul proceselor de batch, reducerea standard a capacității va genera inevitabil erori de tip out-of-memory.
Cartografierea lanțurilor de dependențe între servicii
Infrastructura din cloud este rareori izolată. Modificarea tipului de instanță sau a regiunii de implementare a unei singure baze de date poate introduce involuntar latență de rețea în zeci de microservicii dependente. Înainte de a începe optimizarea, echipele trebuie să construiască hărți precise ale dependențelor.
Telemetria de rețea și datele de tracing distribuit dezvăluie dependențe sincrone ascunse. Dacă un pipeline de ingestie cu volum mare comunică cu un nivel de stocare secundar aflat în altă zonă de disponibilitate, migrarea acelui nivel către un tip de instanță mai ieftin, dar cu limite inferioare de lățime de bandă, va provoca limitări imediate ale vitezei. Înțelegerea acestor blocaje previne transformarea unor economii financiare localizate în latență generalizată la nivelul întregului sistem.
Cuantificarea cheltuielilor operaționale și a costurilor de inginerie
Eforturile de optimizare financiară generează cheltuieli operaționale ascunse care depășesc frecvent economiile nominale de infrastructură. Migrarea unei baze de date monolitice către o arhitectură distribuită, multi-regională, pentru a utiliza instanțe spot sau niveluri de stocare ierarhizate introduce un efort semnificativ de mentenanță.
Echipele inginerești trebuie să calculeze costul total de proprietate, luând în considerare timpul necesar pentru gestionarea instrumentelor personalizate complexe, depanarea întreruperilor tranzitorii ale instanțelor și gestionarea scenariilor de rezervă. Dacă salvarea a câteva sute de dolari pe lună necesită zeci de ore de inginerie pentru a menține scripturi de automatizare fragile, efortul de optimizare funcționează în pierdere netă.
Analiza modelelor de acces la date și a politicilor de retenție
Cheltuielile cu stocarea reprezintă adesea părți substanțiale din facturile de cloud, totuși multe organizații nu au vizibilitate asupra vitezei de acces la date. Înainte de a migra volume către niveluri de arhivare mai ieftine sau de a implementa politici agresive de ciclu de viață, echipele trebuie să analizeze frecvențele de citire și scriere.
Nivelurile de stocare la rece impun de obicei taxe de recuperare și penalizări de latență. Dacă o aplicație solicită în mod neașteptat date de telemetrie arhivate pentru a satisface un audit sau o interogare în timp real, costurile de recuperare pot eclipsa rapid economiile obținute prin stocarea ieftină a datelor. Jurnalele detaliate de acces asigură că politicile ciclului de viață se aliniază cu comportamentul real al aplicației.
Lista de verificare pre-optimizare
- Capturați valorile de utilizare a resurselor P95 și P99 pe parcursul unui ciclu de afaceri complet.
- Cartografiați toate dependențele sincrone și asincrone dintre servicii.
- Auditați frecvențele de acces la date și cerințele de latență pentru recuperare.
- Calculați costul de inginerie comparativ cu economiile financiare estimate.
- Identificați sarcinile de lucru critice care sunt scutite de scalare sau terminare automată.
- Stabiliți alerte automate pentru degradarea performanței după modificarea resurselor.
Concluzie
Optimizarea eficientă a costurilor în cloud este o disciplină inginerească ancorată în măsurare și gestionarea riscurilor, nu un simplu exercițiu de oprire a resurselor inactive. Prin stabilirea riguroasă a nivelurilor de bază, înțelegerea rețelelor complexe de dependențe și luarea în considerare a costurilor operaționale totale, echipele pot reduce cheltuielile de infrastructură în siguranță. Măsurarea prealabilă garantează că eficiența financiară nu vine niciodată în detrimentul rezilienței sistemului.