Oboseala provocată de alerte rămâne unul dintre principalii factori ai epuizării inginerilor și ai incidentelor de producție nerezolvate la timp. Atunci când o echipă de gardă primește zeci de notificări inutile zilnic, semnalele critice se pierd în zgomotul de fond. Infrastructura SaaS modernă necesită o abordare deliberată a observabilității, îndepărtându-se de metricele de epuizare a resurselor și concentrându-se pe simptomele centrate pe utilizator. Acest articol explorează modul în care se poate arhitectura o strategie de alertare eficientă, care protejează sănătatea operațională fără a compromite moralul echipei.
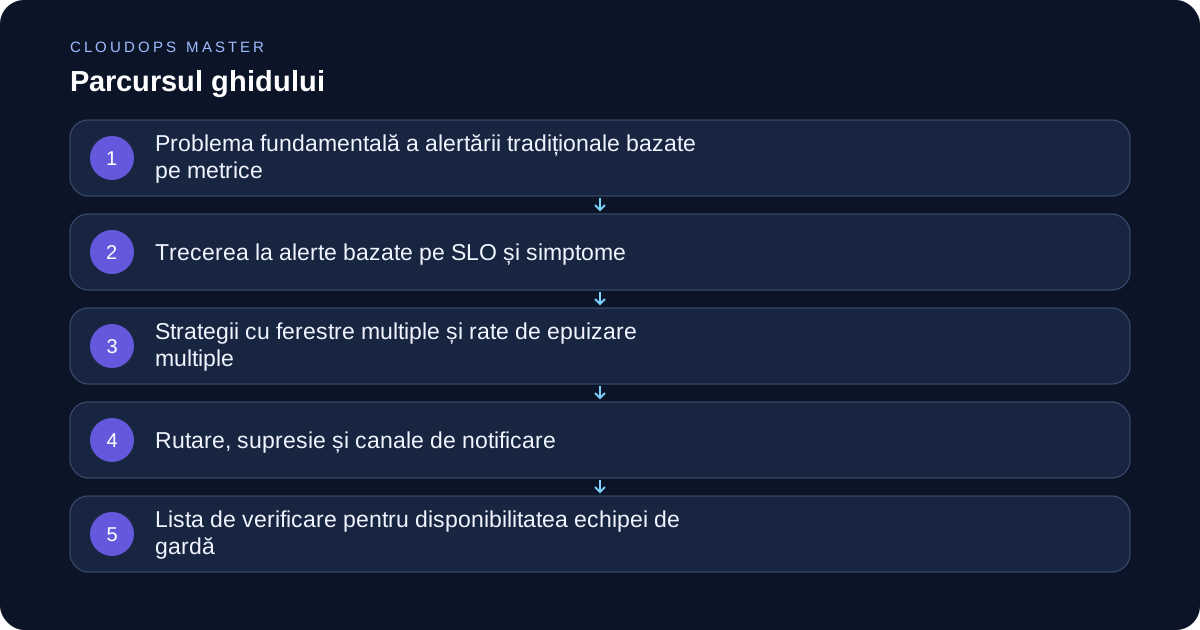
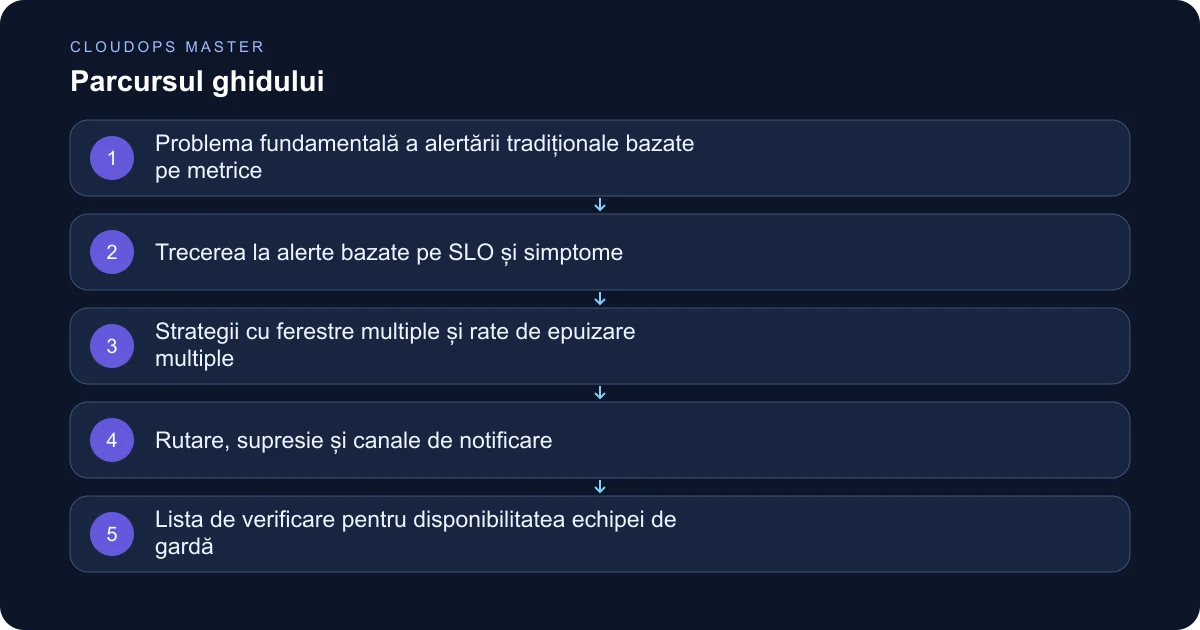
Problema fundamentală a alertării tradiționale bazate pe metrice
Monitorizarea tradițională se bazează adesea pe praguri statice pentru utilizarea CPU, consumul de memorie sau gradul de ocupare al discului. Deși aceste metrice oferă un context istoric, ele corelează rar și direct cu impactul asupra utilizatorului. O instanță care rulează la 95 la sută utilizare CPU nu reprezintă un incident dacă cererile se finalizează cu succes în cadrul indicatorilor de latență stabiliți. În schimb, un serviciu care returnează erori HTTP 500 din cauza unui blocaj în baza de date poate trece neobservat dacă utilizarea CPU rămâne modestă.
Bazarea pe metrice brute generează alerte false care antrenează inginerii să ignore notificările. Atunci când fiecare oscilație minoră a infrastructurii declanșează o pagină urgentă, personalul de gardă dezvoltă obiceiuri defensive, cum ar fi mutarea canalelor sau ignorarea notificărilor până la o verificare secundară. Această dinamică distruge integritatea căii de escaladare și crește timpul mediu de recuperare atunci când apar defecțiuni reale.
Trecerea la alerte bazate pe SLO și simptome
Obiectivele la nivel de serviciu oferă fundamentul matematic pentru o alertare sustenabilă. În loc să generați alerte atunci când o resursă este solicitată, alertați atunci când experiența utilizatorului se degradează dincolo de un prag acceptabil. Alertarea bazată pe simptome se concentrează pe rezultatul sistemului — ceea ce experimentează utilizatorul sau consumatorul din aval — și nu pe starea internă a componentelor individuale.
La proiectarea acestor reguli, măsurați disponibilitatea și latența. De exemplu, în loc să declanșați o alertă pentru un consum ridicat de memorie pe un nod de lucru, alertați atunci când durata de procesare a cozii depășește o limită care amenință fereastra zilnică de finalizare. Acest lucru izolează alerta de defecte reale ale logicii debusiness. Există compromisuri: alertele bazate pe simptome pot ocazional să ascundă cauza principală, necesitând ca inginerii să sape mai adânc în instrumentele de urmărire, dar reduc drastic alertele false prin filtrarea evenimentelor de infrastructură care se auto-repară.
Strategii cu ferestre multiple și rate de epuizare multiple
Pentru a echilibra urgența cu acuratețea, adoptați modele de alertare cu ferestre multiple și rate de epuizare multiple, popularizate de cadrele de Site Reliability Engineering. În loc de un singur prag, calculați cât de repede se epuizează bugetul de erori pe diferite orizonturi de timp.
O rată de epuizare rapidă — cum ar fi consumarea a doi la sută dintr-un buget de erori în cinci minute — justifică o alertă imediată, deoarece sistemul se confruntă cu o întrerupere severă. O rată de epuizare lentă — cum ar fi consumarea a zece la sută pe parcursul a douăzeci și patru de ore — ar trebui să genereze un tichet pentru următoarea zi lucrătoare, în loc să trezească un inginer la miezul nopții. Această nuanță previne furtunile de alerte în timpul unor probleme minore de rețea care se rezolvă singure, detectând în același timp degradările lente înainte ca acestea să provoace defecțiuni majore.
Rutare, supresie și canale de notificare
Nu toate notificările necesită intervenție umană. Stabilirea unei ierarhii stricte a nivelurilor de severitate asigură că mesajele ajung la mediul adecvat fără perturbări inutile:
- Pagini: Rezervate pentru degradări active, neameliorate și vizibile pentru utilizator, care necesită intervenție manuală imediată.
- Tichete: Create automat pentru anomalii cu urgență redusă, constrângeri de resurse sau epuizare lentă a bugetului de erori.
- Jurnale și tablouri de bord: Depozite pasive pentru erori tranzitorii care se auto-repară sau necesită investigații doar în timpul analizelor post-mortem.
Suprimarea alertelor zgomotoase în timpul ferestrelor de întreținere planificate sau al dependențelor din amonte cunoscute este esențială. Cu toate acestea, evitați suprimările permanente pentru probleme nerezolvate; în schimb, urmăriți-le ca elemente de datorie tehnică cu termene limită de remediere atribuite.
Lista de verificare pentru disponibilitatea echipei de gardă
- [ ] Fiecare alertă se corelează direct cu un simptom vizibil pentru utilizator sau cu o încălcare iminentă a unui SLO.
- [ ] Pragurile statice de resurse (CPU, RAM) sunt direcționate exclusiv către sisteme de ticketing non-urgente.
- [ ] Logica ratelor de epuizare pe ferestre multiple este implementată pentru metricele critice de disponibilitate și latență.
- [ ] Manualele de intervenție sunt legate direct în payload-ul notificării, cu pași preciși de remediere.
- [ ] Echipele de gardă revizuiesc regulat ratele de alerte false în cadrul ședințelor retrospective.
- [ ] Canalele de notificare sunt segmentate după severitate în pagini, tichete și jurnale pasive.
Concluzie
Proiectarea unor alerte eficiente necesită o schimbare culturală și tehnică, îndepărtându-se de paranoia legată de infrastructură și orientându-se spre fiabilitatea centrată pe utilizator. Concentrându-vă pe simptome, implementând rate de epuizare pe ferestre multiple și impunând ierarhii stricte de rutare, echipele de inginerie pot elimina zgomotul și pot păstra siguranța psihologică a rotațiilor de gardă. Atunci când alertele sunt rare, relevante și acționabile, inginerii răspund cu viteză și precizie, transformând monitorizarea dintr-o sursă de epuizare într-o garanție fiabilă a stabilității producției.