Echipele mici de inginerie se confruntă adesea cu dificultăți în gestionarea fiabilității deoarece cadrele de lucru enterprise pentru Obiective de Nivel de Serviciu presupun personal dedicat pentru ingineria fiabilității. Când patru dezvoltatori administrează o arhitectură SaaS complexă, adoptarea zeci de ținte de disponibilitate creează o oboseală imediată cauzată de alerte și o sarcină administrativă ridicată. Alegerea unor SLO-uri practice necesită o concentrare disciplinată pe valoarea oferită utilizatorului, mai degrabă decât pe metricile de vanitate ale infrastructurii interne. Prin limitarea țintelor inițiale la parcursurile esențiale, echipele mici pot menține sănătatea sistemului fără a sacrifica viteza de livrare.
Capcana țintelor centrate pe infrastructură
Multe echipe își încep călătoria privind fiabilitatea prin măsurarea utilizării procesorului, a pragurilor de memorie și a spațiului pe disc pentru fiecare mașină virtuală și container. Deși aceste metrici contează în timpul triajului incidentelor, ele nu reflectă experiența reală a clientului. O aplicație poate avea o utilizare a procesorului de nouăzeci și nouă la sută în timp ce procesează cu succes fiecare cerere, sau poate sta complet inactivă în timp ce nu reușește să se conecteze la baza de date. Selecția practică a SLO-urilor începe prin ignorarea indicatorilor de resurse interne și prin concentrarea exclusivă pe punctele finale destinate clienților.
Identificarea parcursurilor esențiale ale utilizatorului
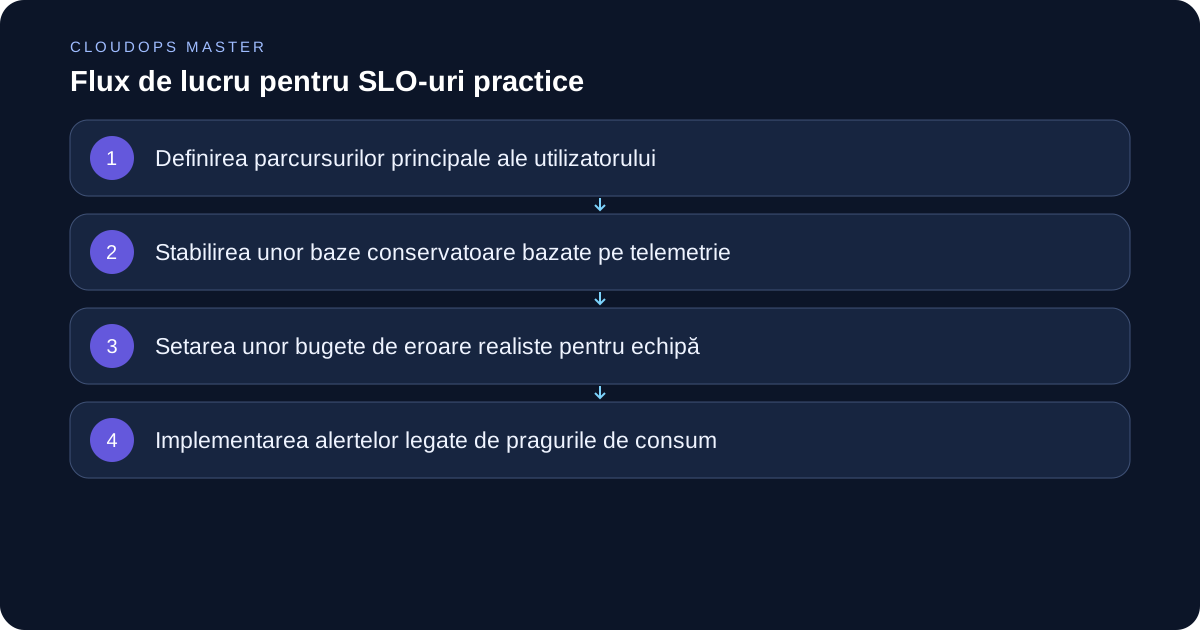
O echipă mică trebuie să prioritizeze fără milă fluxurile de lucru care merită o măsurare formală. Analizați jurnalele aplicației și volumele de tranzacții pentru a găsi cele mai critice trei operațiuni care generează venituri sau susțin utilitatea principală a produsului. Pentru o aplicație SaaS tipică, aceste parcursuri includ de obicei autentificarea utilizatorului, crearea datelor principale și preluarea datelor. Dacă autentificarea eșuează, întreaga aplicație devine inutilizabilă. Dacă un export secundar de raportare eșuează, utilizatorii pot încerca de obicei din nou mai târziu. Limitați numărul inițial de SLO-uri la aceste căi primare pentru a menține costurile operaționale la un nivel gestionabil.
Stabilirea valorilor de bază din realitate
Nu inventați niciodată ținte arbitrare, cum ar fi patru de nouă disponibilitate la început. Examinați datele de monitorizare existente din ultimele nouăzeci de zile pentru a determina performanța dvs. istorică reală. Dacă arhitectura actuală oferă în mod natural o disponibilitate de nouăzeci și opt virgulă cinci la sută din cauza dependențelor de furnizori sau a ferestrelor de întreținere programate, stabilirea unui obiectiv de nouăzeci și nouă virgulă nouă la sută garantează paginarea constantă și epuizarea imediată a echipei. SLO-ul dvs. inițial ar trebui să reflecte realitatea operațională curentă, lăsând loc pentru îmbunătățiri iterative pe măsură ce reziliența crește.
Gestionarea bugetelor de eroare și a ratelor de consum
Un buget de eroare reprezintă cantitatea acceptabilă de instabilitate pe care o poate experimenta sistemul înainte ca încrederea utilizatorilor să scadă. În loc să tratați fiecare mică eroare ca pe o urgență, legați alertele de ratele de consum ale bugetului de eroare. Dacă o creștere rapidă a eșecurilor amenință să consume întregul buget lunar de eroare în câteva ore, alertați imediat inginerul de gardă. Dacă bugetul se epuizează lent de-a lungul săptămânilor, convertiți problema într-un tichet pentru următorul sprint. Acest lucru previne alarmele false și menține ingineria concentrată pe o arhitectură sustenabilă.
Lista de verificare pentru implementarea practică a SLO
- Identificați trei parcursuri esențiale ale utilizatorului care impactează direct succesul clientului.
- Auditați ultimele nouăzeci de zile de telemetrie pentru a stabili performanțe de bază realiste.
- Definiți bugete de eroare care se aliniază cu frecvența actuală de implementare și dimensiunea echipei.
- Configurați reguli de alertă bazate pe ferestre multiple de consum în loc de praguri statice.
- Programați o revizuire lunară pentru a ajusta țintele pe măsură ce arhitectura sistemului evoluează.
Concluzie
Selectarea unor SLO-uri practice este un exercițiu de gestionare a constrângerilor pentru echipele de inginerie cu resurse limitate. Renunțând la cadrele complexe și concentrându-se strict pe parcursurile esențiale, grupurile mici pot obține o fiabilitate ridicată fără a sacrifica viteza de livrare. Începeți la scară mică, bazați-vă țintele pe telemetria istorică și tratați bugetele de eroare drept ghidaje pentru livrarea sustenabilă a software-ului.