Sistemele de monitorizare sunt menite să protejeze mediile de producție, dar alertele prost concepute obțin adesea opusul. Când inginerii de gardă sunt bombardați cu zeci de notificări neacționabile în fiecare noapte, oboseala își spune cuvântul. Semnalele critice sunt ignorate, timpii de răspuns cresc, iar fiabilitatea sistemului scade. Construirea unei strategii durabile de alertare necesită mutarea accentului de la starea internă a componentelor la impactul real asupra utilizatorului. Această abordare reduce zgomotul și asigură că o alertă impune o acțiune imediată.
Trecerea de la monitorizarea cauzelor la cea a simptomelor
Alertarea tradițională se bazează adesea pe urmărirea cauzelor subiacente, cum ar fi utilizarea ridicată a procesorului, presiunea memoriei sau avertismentele privind spațiul pe disc. Deși aceste valori contează în timpul depanării, ele rareori indică o defecțiune actuală prin ele însele. Un server care rulează la nouăzeci la sută din capacitatea procesorului nu eșuează neapărat dacă cererile sunt procesate rapid. Alertarea pe cauze generează un volum masiv de alerte false.
În schimb, sistemele SaaS moderne ar trebui să acorde prioritate monitorizării bazate pe simptome. Concentrați-vă pe metrici care reflectă experiența utilizatorului, cum ar fi rate crescute de erori HTTP, percentile de latență prelungite sau tranzacții eșuate. Dacă o constrângere de resursă nu degradează experiența clientului, ea aparține unui tablou de bord, nu unui canal urgent. Această distincție separă zgomotul operațional de incidente.
Stabilirea obiectivelor SLO și a bugetelor de eroare
Obiectivele de nivel de serviciu oferă o bază matematică pentru o alertare sănătoasă. Fără obiective clare, fiecare mică fluctuație pare o urgență. Prin definirea unor ținte acceptabile de disponibilitate și latență, echipele stabilesc un buget de eroare. Alertele ar trebui să se declanșeze atunci când rata de consum a acelui buget amenință fiabilitatea serviciului într-un anumit interval de timp.
Alerta bazată pe ferestre multiple și rate de ardere oferă un mecanism fiabil. De exemplu, o alertă se poate declanșa dacă două la sută din bugetul de eroare este consumat în cinci minute. Acest model surprinde atât întreruperile catastrofale bruște, cât și degradările lente, ignorând în același timp vârfurile tranzitorii izolate care se rezolvă singure.
Standardizarea manualelor și a rutării
O alertă fără o cale clară de remediere este doar o întrerupere. Fiecare alertă de producție trebuie să includă un link către un manual concis care subliniază pașii de diagnosticare și căile de escaladare. Dacă un inginer primește o pagină la ora trei dimineața, el nu ar trebui să ghicească ce sistem a generat semnalul sau cum să interogheze jurnalele relevante.
Regulile de rutare trebuie să reflecte și responsabilitatea organizațională. Trimiterea avertismentelor de infrastructură către inginerii de produs creează confuzie. Rutati alertele strict pe baza persoanei care are contextul și autorizația de a rezolva problema de bază. Păstrați canalele de Notificare curate, structurate și integrate cu instrumentele de gestionare a incidentelor.
Lista de verificare pentru reglarea alertelor
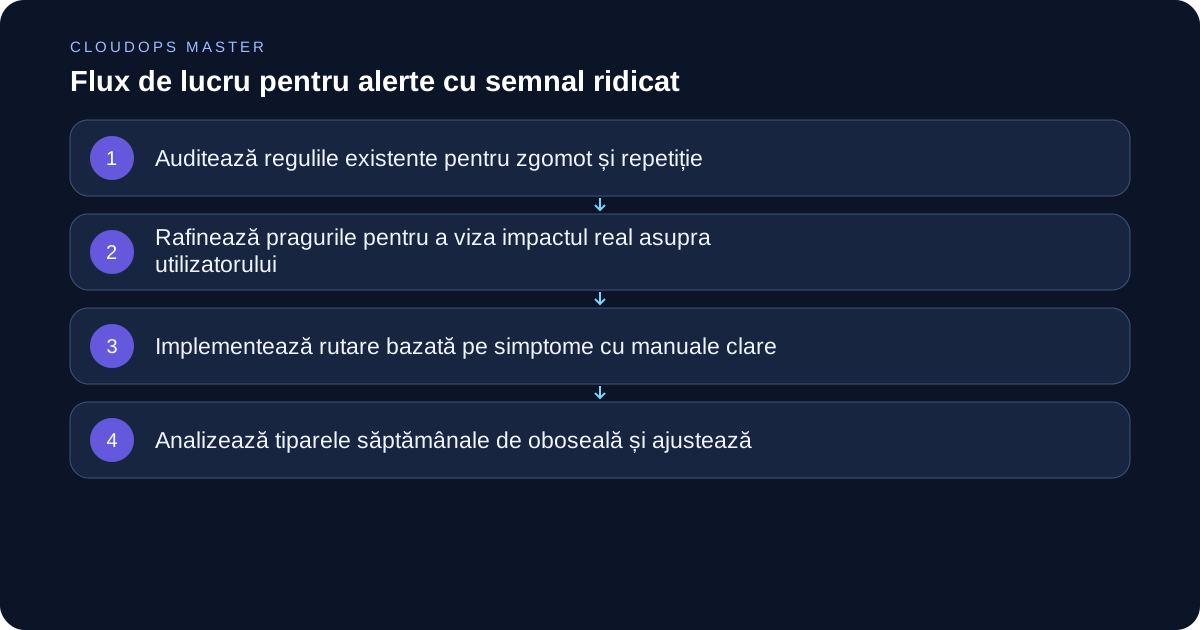
- Auditați toate alertele existente și clasificați-le în funcție de impactul real asupra utilizatorului.
- Eliminați orice alertă care se declanșează de mai mult de trei ori pe săptămână fără intervenție umană.
- Asigurați-vă că fiecare alertă de producție rămasă include un link verificat către manual.
- Implementați alerte bazate pe rate de ardere pentru obiectivele critice de nivel de serviciu.
- Programați o ședință lunară de revizuire a alertelor pentru a evalua falsurile pozitive.
Când acest sfat nu se aplică
În timp ce alertarea bazată pe simptome funcționează excepțional de bine pentru aplicațiile SaaS distribuite, aceste practici necesită modificări în medii specializate. De exemplu, sistemele încorporate critice pentru siguranță, software-ul de control industrial în timp real sau platformele financiare stricte necesită adesea notificarea imediată a unor defecte hardware specifice, cu mult înainte ca un client să experimenteze o defecțiune. În aceste domenii, costul unei degradări hardware nedetectate depășește riscul oboselii de alertă.
Concluzie
Proiectarea unor alerte utile este o disciplină inginerică continuă, nu o sarcină unică de configurare. Prioritizând valorile bazate pe simptome, utilizând bugetele de eroare și menținând standarde riguroase pentru manuale, echipele pot elimina oboseala legată de alerte și pot păstra moralul. Un pager silențios nu este un semn de noroc chior; este rezultatul direct al unui design de infrastructură deliberat.